Negação do racismo no TripAdvisor: estratégias discursivas

O racismo, como elemento pervasivo, se manifesta de formas particulares nos campos do turismo e hospitalidade. Viajantes, pesquisadores e ativistas experienciam e analisaram isto em novas plataformas digitais semi-automatizadas por interfaces e algoritmos como Airbnb, levando empreendedores a criar plataformas de hospedagemagências de turismo mais seguras.

Durante viagens para outros locais ou países, os viajantes racializados são mais fragilizados, estando sujeitos a atos racistas que dificilmente serão confrontados imediatamente devido ao risco intensificado. Plataformas de reviews online, entretanto, pode(ria)m ser um dos espaços de reação através do relato das experiências negativas.

Leia texto relacionado “Traveling while black” no blog For Harriet

O artigo Traveling Across Racial Borders: TripAdvisor and the Discursive Stragies Business Use to Deny Racism, entretanto, apresenta resultados assustadores de pesquisa de Heather M. Dalmage da Roosevelt University. Publicado na revista Sociology of Race and Ethnicity, o artigo aplica análise de discurso para entender como os hotéis e restaurantes respondem e negam atitudes racistas especificamente ao receber casais interraciais.

A autora apresenta um histórico sobre os processos de racialização do Outro e como são especialmente intensos em países de maioria branca. Escrevendo do ponto de vista de uma pesquisadora estadunidense, Dalmage revisa as categorias de casais e comunidades inter-, multi- e bi-raciais para, em seguida, adentrar nas particularidades das plataformas digitais. Citando Hughey e Daniels, explica que “raça e racismo persistem online em modos que são tanto novos e específicos na Internet, junto a vestígios de formas seculares que reverberam tanto off quanto online“. Ao analisar a interface da plataforma, guias de como responder a avaliações de hóspedes de consultorias e da própria TripAdvisor, a autora identificou que as recomendações explicitamente invisibilizam a questão, ignorando como lidar com casos de racismo.

O estudo inédito reuniu 233 casos no TripAdvisor, através de buscas por termos como relacionamento interracial. Deste total, apenas 50 foram respondidos e entraram na fase de análise de discurso. A autora identificou que a maior parte seguem um padrão discursivo de negação da raça e do episódio racista, com o objetivo de patologizar os casais avaliadores.

Quatro táticas foram identificadas e são detalhadas na seção seguinte: (a) “Você está errado! Eu não sou racista”; (b) Explicação não ligada à raça; (c) “Nós tratamos todos do mesmo jeito”; (d) “Você entendeu errado e/ou poderia ter evitado a experiência negativa se tivesse agido diferente”. Nas conclusões, a autora explica como, em um mundo racializado e estruturado pela supremacia Branca, as práticas de evasão de debate sobre raça e racismo servem aos ideais neoliberais deste mundo. A análise do discurso é especialmente importante pois “as fronteiras raciais, desenvolvidas através da colonização e capitalismo global e infundidas em identidades, ideologias e instituições agora estão sendo criadas em novos e não tão novos modos online”.

Leia o artigo completo na revista Sociology of Race and Ethnicity.
Digital Media Winter Institute 2019 em Lisboa: inscrições abertas

Digital Media Winter Institute da Universidade Nova de Lisboa reúne dois eventos entre 28 de janeiro e 07 de fevereiro: SMART Data SprintInterpreting Cross-Platform Digital Networks e está com inscrições abertas!

Smart Data Sprint acontece de 28 de janeiro a 01 de fevereiro e reúne uma série de atividades voltadas a doutorandos e pesquisadores durante uma semana. Nos primeiros dias, os participantes poderão ver palestras e practical labs realizados por pesquisadores que definem a pesquisa em mídias sociais e digital methods em torno do mundo. O destaque deste ano é a participação de Richard Rogers, líder do Digital Methods Initiative da Universidade de Amsterdam. Ocorrerão também palestras e practical labs sobre análise de redes com Gephi e NodeXL, modelagem de tópicos, text analytics, query design e outras temas relevantes com pesquisadores como Inês Amaral, Bernhard Rieder, Janna Joceli, Beatrice Gobbo e André Mintz.

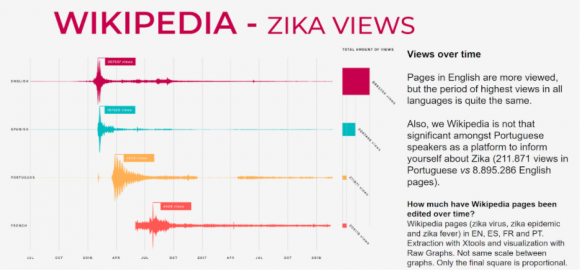
O grande objetivo do evento, porém, é a realização dos chamados data sprints – trabalho intensivo de análise de dados a partir de problemas de pesquisa apresentados em “pitchs”. Cada participante deverá escolher uma equipe e trabalhará junto aos líderes dos projetos e colegas de vários países do mundo durante 3 dias. Eu e André Mintz levaremos o projeto “Interrogating Vision APIs“, no qual estudaremos datasets sobre o avanço da estética de ultra-direita nas eleições brasileiras com o uso de visão computacional oferecida por APIs da Google Vision, IBM Watson e Microsoft Azure. Outros projetos submetidos são: “Health myths’ circulation on social media“, da Elaine Rabello (UERJ); “Frugal Innovation” por Miguel Amaral (Universidade de Lisboa) e Elsa Caetano (iNOVA Media Lab); e “Journalism Apps“, por Dora Santos Silva (NOVA FCSH) e Mariana Scalabrin Muller (Universidade do Minho e Universidade NOVA). Participei da edição de 2018 em equipe da Elaine Rabello e Gustavo Matta (FioCruz) analisando a circulação de informação sobre o zika vírus e recomendo o trabalho. Veja uma das visualizações e clique para ver o relatório completo:

Na segunda semana acontece o workshop Interpreting Cross-Platform Digital Networks. São 12 horas de workshop de 4 a 7 de fevereiro. Janna Joceli Omena, coordenadora do SMART Data Sprint e doutoranda no Digital Media UT Austin/Portugal da Universidade Nova de Lisboa. O curso vai apresentar metodologia para interpretar redes digitais entre diferentes plataformas, incluindo exercícios práticos de extração, análise e visualização. Conheça alguns trabalhos da Janna Omena em seu blog e ResearchGate. É possível se inscrever no data sprint e no workshop ou em cada evento separadamente.

Veja abaixo vídeo-resumo do evento e uma entrevista que realizei com a Janna Omena e não esqueça: inscrições abertas até 13 de janeiro.


Como deletar todo seu histórico no Facebook – ou como deletar posts em massa

O oligopólio de algumas plataformas como Facebook incomoda cada vez mais usuários. Entretanto, o “efeito de rede” – entre outros – impede uma transição em massa de usuários ou, mesmo, a desejada descentralização da internet. Uma alternativa à exclusão completa dos perfis – difícil de ser realizada por pessoas públicas ou quem trabalha com comunicação – é diminuir a quantidade de publicações, inclusive do histórico.

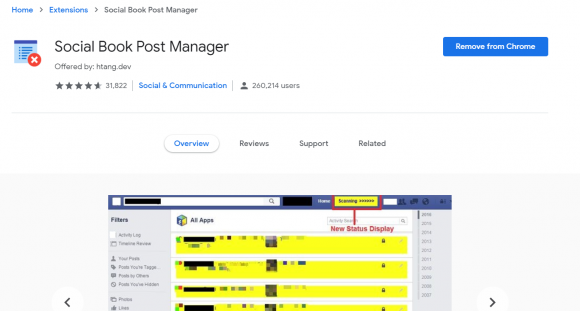
Use o plugin “Social Book Post Manager” para Google Chrome e delete o conteúdo publicado na rede de forma simples. O recurso pode ser instalado através do link a seguir:

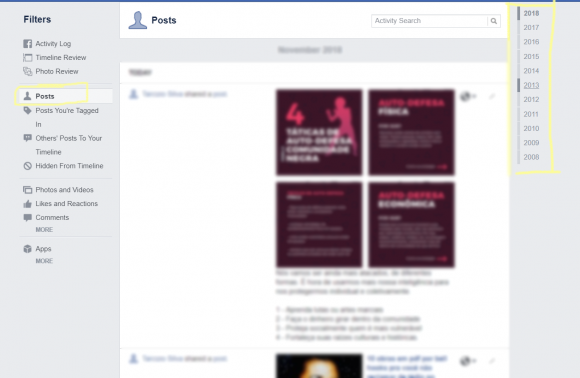
Depois da instalação, os passos são bem simples! Vá a seu perfil e clique em “Registro de Atividades” ou “Activity Log”. No lado esquerdo, selecione por onde você começar. Por exemplo, “Publicações” ou “Posts” de 2010, digamos.

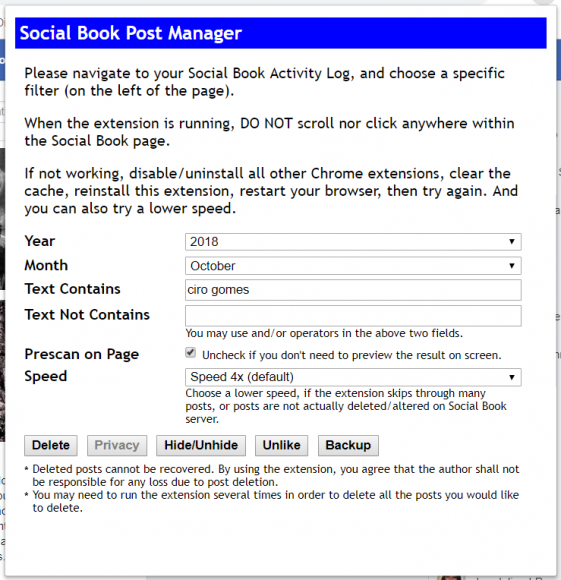
O processo de exclusão é um pouco demorado, então recomendo ir de ano a ano ou, mesmo, de mês a mês se você for um heavy user. Além de selecionar ano e mês, é possível adicionar uma palavra-chave específica.

Dica do MacObserver.

“Tecnologias não são neutras” – trecho do levantamento PretaLab

[O texto abaixo faz parte do levantamento inédito PretaLab, levantamento realizado pela Olabi com 570 mulheres negras e índigenas no Brasil. Artigos analíticos, dados completos e destaques podem ser acessados em www.pretalab.com ]

Um estudo feito em 2017 pelo Law’s Center on Privacy and Technology, o centro sobre privacidade e tecnologia da faculdade de direito da Universidade de Georgetown, estima que 117 milhões de cidadãos já estejam nos bancos de dados que a polícia pode usar. “O reconhecimento facial vai afetar afroamericanos desproporcionalmente. Muitos departamentos de polícia não percebem isso”, diz o estudo. Outro documento do FBI sugere que “o reconhecimento facial é menos preciso em negros. Além disso, devido à desproporção no número de negros presos, sistemas que utilizam fotos realizadas no momento da prisão incluem mais afroamericanos. “Apesar dessas descobertas, não há nenhum estudo independente com testes para viés racistas nestes programas”, conclui o estudo.

Iniciativas como a Algorithmic Justice League [em português, Liga da Justiça do Algoritmo] buscam denunciar e acabar com o racismo implícito em programas de inteligência artificial. Fundadora da iniciativa, Joy Buolamwini percebeu que programas de reconhecimento artificial nem sempre conseguem detectar rostos negros, problema causado pela falta de diversidade das equipes que criam esses programas e das imagens que as máquinas recebem para aprender a “enxergar” esses rostos. “A visão do computador usa inteligência artificial para fazer o reconhecimento facial. Você cria uma série de imagens com exemplos de rostos. No entanto, se essas séries não são diversas o suficiente, qualquer rosto que desvie da ‘norma’ será difícil de reconhecer”, ela disse em uma Ted Talk.

Enquanto as estatísticas, estudos e políticas públicas voltadas para mulheres negras ignorarem a importância da tecnologia, as mulheres negras vão estar à margem de decisões cada vez mais centrais na sociedade. “Se as mulheres negras não estiverem nesse processo, se não existirem ações para que elas estejam nesse processo, vamos perder totalmente nosso poder de integração no mundo”, afirma Silvana.

A tecnologia representa ainda uma possibilidade de geração de renda e de emancipação econômica, já que o setor cresce e costuma ter salários atrativos. Nos Estados Unidos, dados compilados pela pesquisa econômica Glassdoor mostra que os empregos da área de tecnologia, engenharia e ciência foram os mais bem pagos de 2017. Mas o desigual acesso à educação e a forte presença de estereótipos e preconceitos seguem afastando as mulheres negras dos estudos e de uma carreira nessas áreas.

A desigualdade e as barreiras já surgem quando são observados apenas os dados de gênero na tecnologia. Uma pesquisa que analisou a presença feminina em Ciência, Tecnologia e Engenharia no Brasil, China, EUA e Índia concluiu que mulheres abandonam a indústria tecnológica porque são tratadas injustamente, recebem salários menores e apresentam menos chances de serem promovidas do que seus colegas do sexo masculino. No Brasil, 29% das mulheres entrevistadas se sentem estagnadas em seus trabalhos e 22% acham que podem desistir da carreira no próximo ano.

Apesar de todas as barreiras que precisam enfrentar, estudos mostram que o trabalho das mulheres nesta área pode ser tão bem ou melhor avaliado do que de seus colegas do sexo masculino. Pesquisadores descobriram que os usuários do repositório de software GitHub aprovaram os códigos escrito por mulheres a uma taxa maior do que aqueles escritos por homens, mas apenas caso seu gênero não fosse identificado.


Acesse completo em https://www.pretalab.com/

Disparidades interseccionais em sistemas de classificação automatizada de gênero

Mecanismos de inteligência artificial tal como reconhecimento automatizado de faces são, como toda tecnologia, repletos de particularidades sociais de produção que muitas vezes são deixados de lado em prol de supostas eficiências que trazem mais problemas – geralmente para grupos desprivilegiados.

No artigo Gender Shades – Intersectional Accuracy Disparities in Commercial Gender Classification, as pesquisadoras Joy Buolamwini (MIT Media Lab) e Timnit Gebru (Microsoft Research) apresentam pesquisa sobre vieses interseccionais negativos em sistemas automatizados de classificação. Um agravante é que, na medida em que sistemas de inteligência artificial se baseiam em bases de dados construídas a partir de inputs preexistentes, a tendência é que sistemas derivados intensifiquem os vieses já presentes nas sociedades.

Os exemplos destes vieses são inúmeros. Já falamos aqui sobre estudos sobre reconhecimento de rostos (realizado pela própria Buolamwini), mecanismos de buscas e modelos preditivos para intensificação de vigilância. Nos EUA, mais de 117 milhões de pessoas estão inclusas em redes policiais de identificação de faces – e diferenças na precisão destes sistemas podem arruinar vidas.

No artigo, as autoras apresentam histórico de estudos e debate sobre a construção de bases de treinamento para identificação de gênero para aprendizado de máquina, partindo da discussão de duas bases públicas bastante utilizadas: a IJB-A e o gerado pela Adience. O primeiro, IJB-A, foi criado pelo Intelligence Advanced Research Projects Activity do governo americano e incluía, no momento de produção do artigo, 500 imagens de rostos indivíduos públicos. Já o Adience, por sua vez, possui imagens cerca de 2.284 indivíduos únicos e foi gerada a partir de coleta no Flickr.

Detalhes sobre a base Adience

Mas usar estas bases públicas de treinamento gera bons resultados? Entender os vieses em bases públicas é essencial pois inúmeros softwares e sistemas podem ser construídos de forma derivada a partir deles, reforçando os problemas. E a investigação sobre estas bases permite estabelecer procedimentos para auditoria de sistemas comerciais e sistemas criados/contratados por instituições públicas. Para fim de comparação, então, a autoras criaram uma base de dados própria com procedimentos mais rigorosos.

A Pilot Parliaments Benchmark reúne fotos de 1270 membros parlamentares de seis países: Ruanda, Senegal, África do Sul, Finlândia, Islândia e Suécia. Estes países foram escolhidos por terem proporção relativamente alta de distribuição entre homens e mulheres e representarem tons de pele variados, dos mais escuros aos mais claros. Levando em conta que o construto “raça” é contextual de acordo com cada cultura e país, as autoras optaram por fazer a intersecção de gênero com a variável de cor de pele, a partir da tipologia Fitzpatrick Skin Type, muito usada também por dermatologistas.

Exemplo de faces no Pilot Parliaments Benchmark

Depois de construir o PPB mais preciso e confiável do que as outras bases citadas, as autoras partem então para comparar os resultados dos classificadores comerciais. Buolamwini e Gebru selecionaram IBM Watson, Microsoft Cognitive Services e o Face++  para avaliar a precisão de identificação de gênero no dataset construído. Os resultados variaram de forma impressionante:

  • Todos classificadores foram mais precisos em faces de homens (8,1% – 20,6% diferência de taxa de erro)
  • Todos classificadores performaram melhor em faces mais claras do que faces mais escuras (11,8% contra 19,2% de erro)
  • Todos classificadores performaram pior em faces mais escuras de mulheres (20,8% comparado a 34,7%)
  • Os classificadores da Microsoft e IBM performaram melhor em rotos de homens de pele clara (taxas de erro de 0,0% e 0,3%)
  • Os classificadores do Face++ performaram melhor em rostos masculinos de pele escura (0,7% de taxa de erro)
  • A diferença máxima de taxa de erro entre dois grupos foi de 34,4%!

Ao longo da seção de análise do artigo, as autoras apresentam detalhamento de resultados e comparações entre sub-datasets controlando variáveis como qualidade das imagens. Os resultados apontam inconsistência nas classificações que deixam negros e, sobretudo, mulheres negras em desvantagens, enfatizando a importância de auditoria algorítmica e acompanhamento da sociedade civil sobre agentes artificiais que possam tomar decisões quanto a identificação de pessoas, comunicação automatizada e, sobretudo, aplicações relacionadas a vigilância.

Algorithmic transparency and accountability reach beyond technical reports and should include mechanisms for consent and redress which we do not focus on here. Nonetheless, the ndings from this work concerning benchmark representation and intersectional auditing provide empirical support for increased demographic and phenotypic transparency and accountability in arti cial intelligence.

Assista abaixo um sumário em vídeo do artigo: